Waarom peptidedesign de volgende grens is in AI-geneesmiddelontwikkeling
News Details
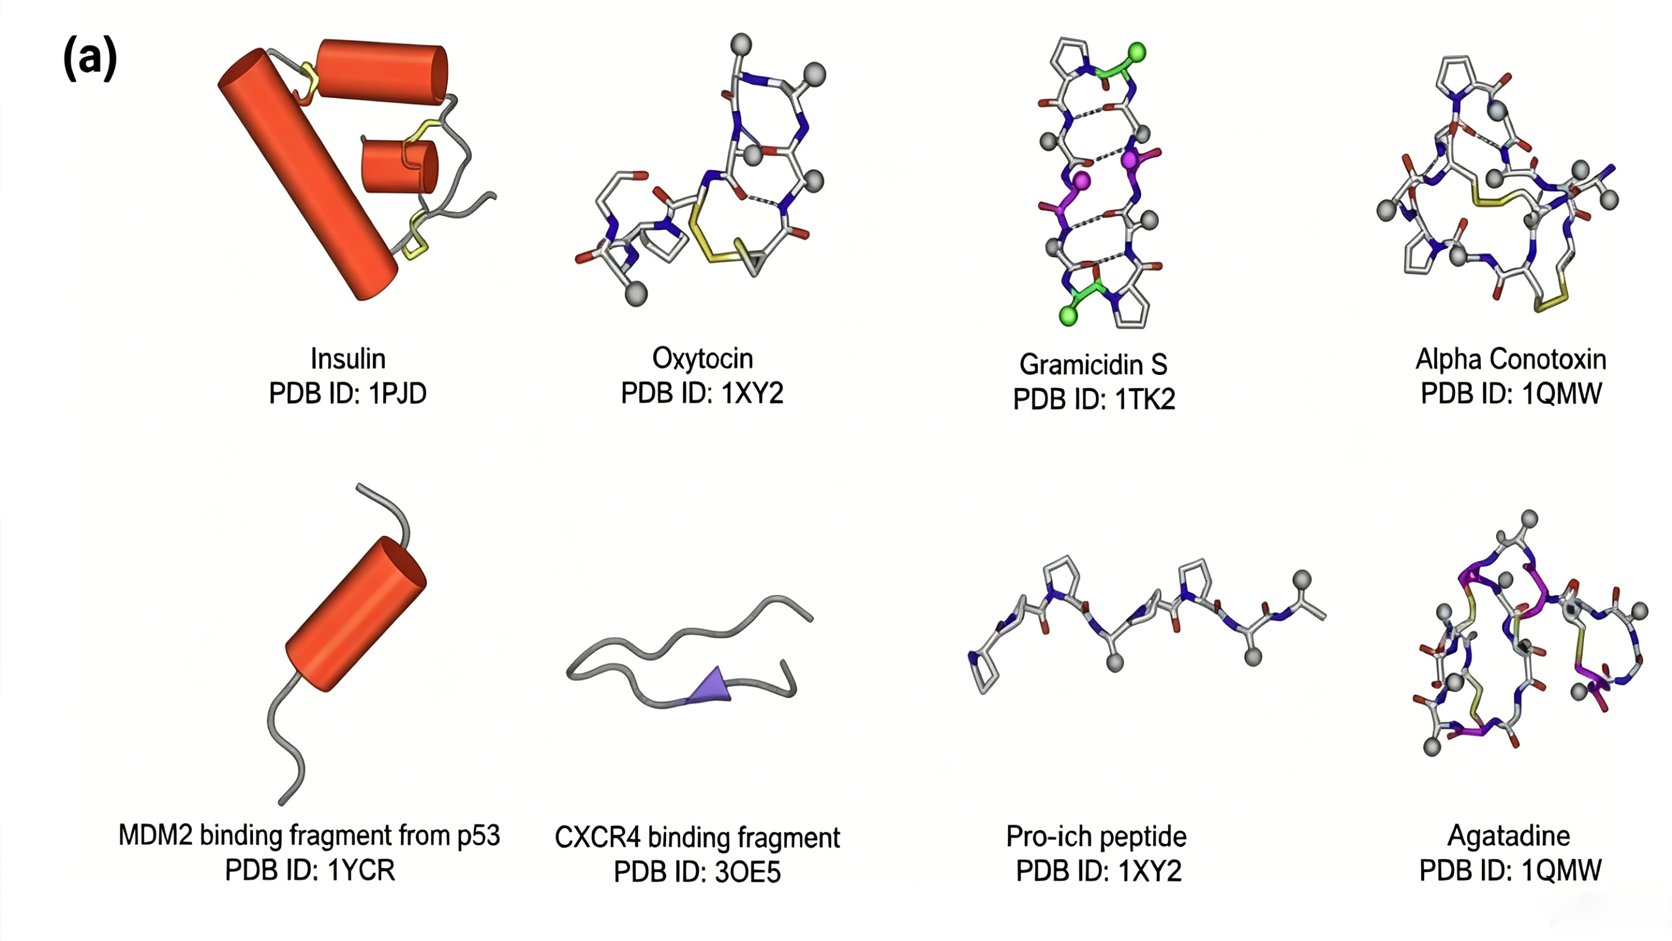
In het landschap van de moderne farmacologie is Peptide Drug Discovery een hoogspannend gebied geworden. Peptiden worden vaak beschreven als het "middenpad" tussen kleine moleculen en biologica en zijn uniek gepositioneerd om doelen aan te pakken die voorheen als "onmiddelbaar" werden beschouwd.
Met de recente explosie van generatieve AI en structurele biologie-modellen gaat AI-gestuurde peptidedesign van laboratoriumcuriositeit over naar een hoeksteen van farmaceutisch R&D. Hier is een diepgaande analyse van waarom peptiden de volgende AI-"breakout"-hit worden.
01 | Het "Goldilocks"-molecuul: Waarom peptiden?
De fundamentele logica voor peptidedrugdiscovery ligt in hun unieke fysische en chemische eigenschappen.
- De kloof overbruggen: Kleine moleculaire geneesmiddelen kunnen vaak niet binden aan grote, ondiepe Protein-Protein Interaction (PPI)-interfaces omdat ze geen diepe "zakken" hebben om in te verankeren.
- Doelgericht op intracellulair ruimte: Hoewel antilichamen (biologica) uitstekend zijn in het identificeren van oppervlakte-eiwitten, voorkomt hun grote grootte dat ze celmembranen passeren om intracellulaire doelen te bereiken.
- Het peptidevoordeel: Peptiden beschikken over voldoende flexibiliteit om zich aan eiwitoppervlakken aan te passen terwijl ze hoge specificiteit en affiniteit behouden. Dit maakt ze de ideale "sleutel" om intracellulaire PPI-doelen te ontgrendelen.
- Bewijsde trackrecord: Peptidetherapie is niet nieuw—van insuline tot meer dan 100 door de FDA goedgekeurde peptidegeneesmiddelen—but AI versnelt dit veld nu tot een fase van snelle ontwikkeling.
02 | De databarrière: Kwaliteit boven kwantiteit
In de wereld van AI is de eerste hurdle niet het model—it’s de Data Foundation. Peptidedesign verschilt significant van algemeen eiwitdesign vanwege de schaarste aan hoogwaardige structurele data.
- Structurele schaarste: Databases zoals ProPedia, PepBDB en CPSet vormen de basis voor training, maar ze worden vaak geplaagd door redundante monsters, korte peptiden of verouderde webhosting.
- Innovative datasourcing: Vooraanstaande onderzoekers behandelen nu eiwitloopregio's als "pseudo-peptide"-bronnen. Omdat lussen peptiedgedrag op structurele en dynamische manieren nabootsen, dienen ze als een vitale referentie om de conformationele ruimte van peptiden te vullen.
- De hybride toekomst: De toekomst van peptidedesign hangt af van de integratie van "Echte experimentele structuren + Virtuele voorspelde structuren (van AlphaFold DB) + Sequenkennis."
03 | Van voorspelling naar design: De drie niveaus van AI-competentie
De evolutie van AI in deze sector volgt een duidelijke trajectorie van toenemende complexiteit.
Niveau 1: Interactievoorspelling
Beantwoorden waar een eiwitoppervlak mogelijk een peptide bindt en kritieke resten identificeren. Modellen zoals PepNN, CAMP en MaSIF integreren eiwitstructuur, sequentie en oppervlaktageometrie om te voorspellen "of en waar" binding plaatsvindt.
Niveau 2: Complexe structuurvoorspelling
Verder gaan dan "of" naar "hoe." Hoewel traditionele docking worstelde met hoogflexibele peptiden, heeft een nieuwe generatie modellen—AlphaFold 3, RoseTTAFold All-Atom, Chai-1 en Boltz-1—multicomponentmodelering revolutionair gemaakt. Echter, systematische benchmarking voor niet-natuurlijke en macrocyclische peptiden blijft een uitdaging.
Niveau 3: Doelgericht design
Dit is de huidige "Hot Zone." AI analyseert niet meer alleen; het genereert nieuwe moleculen van scratch om specifieke doelen te binden.
04 | De drie generatieve routes voor de novo peptidedesign
De review benadrukt drie primaire AI-paden die momenteel concurreren om dominantie in de de novo design van binders.
4.1 Hallucination-Based Design: Iteratieve optimalisatie
Deze "omgekeerde creatie"-logica gebruikt een structurele voorspellingsmodel om te beoordelen of een willekeurige sequentie zich tot de gewenste doelvorm vouwt.
- EvoBind & EvoBind2: Deze modellen hebben geen vooraf bekende bindingsplaatsen nodig. EvoBind2 rapporteerde een hitrate van 75% voor macrocyclische peptiden en 46% voor lineaire peptiden, met affiniteiten variërend van micromolaire tot sub-nanomolaire niveaus.
4.2 Sequence-Structure Co-Design: De Diffusion Revolution
Deze methoden laten de structuur en sequentie samen evolueren tijdens generatie.
- DiffPepBuilder: Gebaseerd op SE(3)-equivariant diffusion, integreert het eiwit-taalmodelembeddings en torsiehoeken.
- PepFlow: Gebruikt flow-matching technieken om hoogwaardige diversiteit in geometrische en energiemetriek te bieden.
4.3 Sequence-Based Methods: Designing for "Disordered" Targets
Veel hoogwaardige doelen (zoals transcriptiefactoren) ontbreken aan stabiele structuren of zijn sterk ongeordend. Voor deze zijn Protein Language Models (pLMs) de superieure keuze.
- PepMLM: Dit model gebruikt "mask filling" aan het einde van een eiwitsequentie om een binder te genereren, met hitrates van meer dan 38%.
- Cut & CLIP: Dit gaat van "Binding" naar "Degradation," met behulp van contrastieve leerzaamheid om peptiden te designen die E3-ligase-gemedieerde degradatie triggeren.
Conclusie: Waarom nu?
De overgang van AI van "predictive assistant" naar "generatieve chemicus" markeert een keerpunt. Door structurele geometrie te combineren met sequentiegebaseerde taallogica, lost AI eindelijk de conformationele complexiteit van peptiden op. Voor drugdiscovery betekent dit een snellere, nauwkeurigere weg naar het richten op het "onmiddelbare" interieur van de cel.


